PPO存在的问题
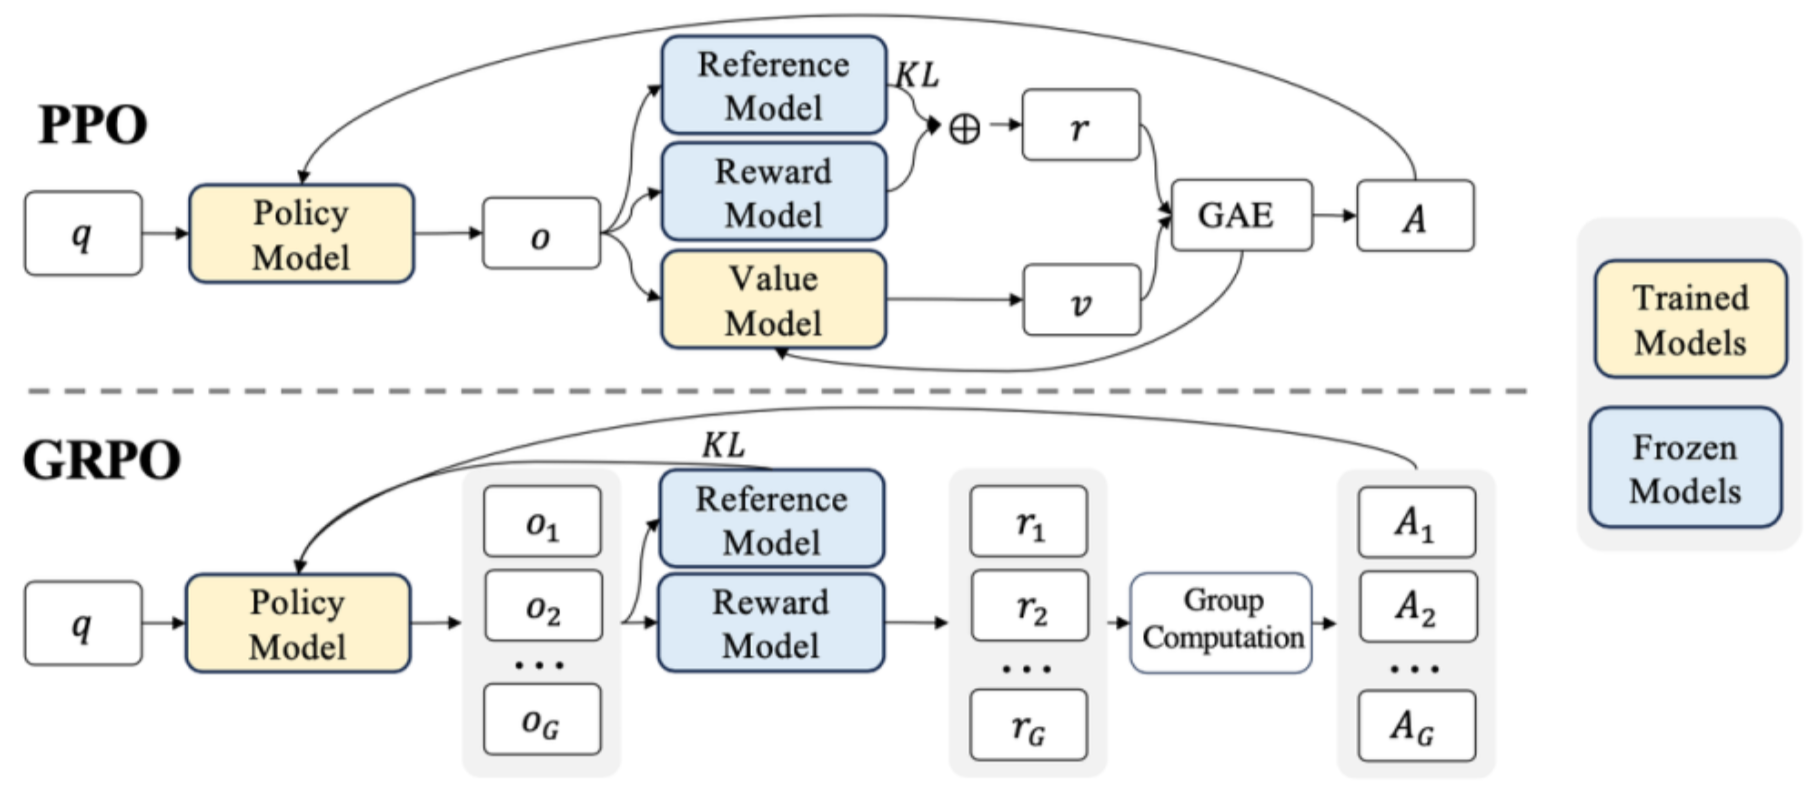
为了计算Actor Model Loss,需要用到4个不同但是均由SFT Model初始化而来的Model。Reference Model参与KL散度计算(计算token-level的奖励);Reward Model和Critic Model参与GAE的计算。
即使在训练过程中仅有Actor和Critic Model需要更新参数,但是四个模型的推理和训练需要占用大量的计算资源,并且也会带来更多的累积误差。
GRPO
去掉Critic Model转而用组相对优势来计算优势函数。
GRPO通过对相同的一个问题 q 用 πθold 采样的多个一组输出 o1,o2...,oG,然后Reward Model对这些回答都给出奖励值,最后给出优势函数的估计。
结果奖励监督
使用传统的ORM(Outcome Reward Model)来进行强化学习过程,在这种情况下,模型对一组输出生成一组奖励值 r={r1,r2,⋯,rG},然后通过下式对优势函数进行估计:
A^i,t=r^i=std(r)ri−mean(r)
上述式子就是对采样的这一组输出的奖励计算归一化奖励作为输出的优势函数。简单理解就是当前第 i 个输出的奖励 ri(q,oi) 比所有输出的奖励平均值高出的优势(可以为负值)
注意:GRPO不同于PPO 那样用 Critic、TD 误差和 GAE把最后奖励向前传播,而是把同一个 Response 优势赋给所有 token
过程奖励监督
结果奖励监督只给整个 Response 一个总分;过程奖励监督会在每一个推理步骤结束时都给一个分数
因此,Process Supervision Model能更细粒度判断:
- 哪一步推理正确
- 哪一步开始出错
- 后面的步骤是否把错误纠正回来
例如模型生成:
问题:求解方程 2x+3=7步骤1:两边同时减去3,得到 2x=4。步骤2:两边同时除以2,得到 x=2。步骤3:代回原方程,等式成立。
PRM 可能分别给出:
r(1)=0.9,r(2)=0.95,r(3)=0.8
表示三个推理步骤都比较可靠。
如果模型生成:
步骤1:两边同时减去3,得到 2x=4。步骤2:两边同时除以4,得到 x=1。步骤3:所以最终答案是 x = 1
PRM 可能给出:
r(1)=0.9,r(2)=−0.8,r(3)=−0.9
这样就能识别出:第一步正确,但第二步开始发生错误。
相关公式:
同样采样group输出,对应的一组奖励值为:
R={{r1index(1),…,r1index(K1)},…,{rGindex(1),…,rGindex(KG)}}
其中 index(j) 为第 j 个步骤的 end token的index,Ki 是第 i 个输出的步骤个数。
riindex(1)表示PRM 在第一个步骤结束处给出的奖励。
GRPO计算优势如下:
A^i,t=index(j)≥t∑r~iindex(j)=index(j)≥t∑std(r)riindex(j)−mean(r)
对于所有采样的输出中的所有步骤 {stepi,j},i∈G,j∈Ki,根据PRM得到奖励值 riindex(j),然后计算得到每一个步骤相对于所有步骤的高出的优势,但是这只是针对单步步骤计算的,实际上我们的response是由多个步骤拼接的,所以当前步骤的优势应当包含后续的期望,即当前步骤的优势值为当前步骤以及后续步骤优势值的和。
第 i 条 Response 中,第 t 个 token 的优势,等于这个 token 所在位置之后所有推理步骤奖励的总和。当前 token 的好坏,不只取决于当前步骤,还要考虑它对后续所有推理步骤产生的影响
GRPO整体更新公式
不管是ORM还是PRM进行强化学习,都用下式进行策略更新:
JGRPO(θ)=E[q∼P(Q), {oi}i=1G∼πθold(O∣q)]G1i=1∑G∣oi∣1t=1∑∣oi∣{min[πθold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)A^i,t, clip(πθold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t),1−ϵ,1+ϵ)A^i,t]−βDKL[πθ∥πref]}
这里的KL散度采用了一个无偏估计等式,加在策略优化项后面,PPO则是将KL散度约束项加到奖励值当中: GRPO:
DKL[πθ∥πref]=πθ(oi,t∣q,oi,<t)πref(oi,t∣q,oi,<t)−logπθ(oi,t∣q,oi,<t)πref(oi,t∣q,oi,<t)−1
PPO:
rt=rφ(q,o≤t)−βlogπref(ot∣q,o<t)πθ(ot∣q,o<t)
DAPO
DAPO 主要解决朴素 GRPO 在长 CoT 训练中出现的几个问题:策略熵坍缩、无效样本增加、长回答中的 token 被低估,以及截断样本带来的奖励噪声。
改进得到DAPO的公式如下所示:
JDAPO(θ)=E(q,a)∼D,{oi}i=1G∼πθold(⋅∣q)∑i=1G∣oi∣1i=1∑Gt=1∑∣oi∣min(ri,t(θ)A^i,t, clip(ri,t(θ),1−ϵlow,1+ϵhigh)A^i,t)
s.t.0<{oi∣is_equivalent(a,oi)}<G, where
ri,t(θ)=πθold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t),A^i,t=std({Ri}i=1G)Ri−mean({Ri}i=1G).
Clip-Higher
把原先对于重要性权重 ri,t(θ)的向上裁剪阈值提高了。对于本身概率就比较低的token来说,策略概率比较低,那么乘以优势值之后就更低了,这对于学习长推理过程以及学习新的推理范式都是限制,限制了对低token的探索。
将阈值上限调整为0.28(消融实验得出),下限不变。
Dynamic Sampling
在训练过程中,每次训练前都进行采样并过滤掉准确率为1和0的prompts。如果GRPO的一个Group内所有的outputs准确率都是1,那么计算得到的该组的优势就是1,这样会导致梯度消失问题;并且随着训练步数增加,准确率为1的回答也是在逐步增加的
Token-Level Loss
对Group内所有outputs的所有token计算loss均值,GRPO在计算loss的时候是先对单个output计算所有token loss的均值,然后在计算output之间的均值,这样会导致组内outputs对于loss贡献的不均衡,较长的Response中的token对总loss的贡献度偏低。
DAPO 不再让每条 Response 权重相同,而是把整个 batch 中所有 token 放在一起求平均,这样batch中每一个token都拥有相同的基本权重。
Overlong Reward Shaping
对过长回答的奖励修改,用一种软惩罚的方法对overlong response进行惩罚,最终叠加到准确率奖励上。
Rlength(y)=⎩⎨⎧0,Lcache(Lmax−Lcache)−∣y∣,−1,∣y∣≤Lmax−LcacheLmax−Lcache<∣y∣≤Lmax∣y∣>Lmax
GSPO
